二分类#
术语解释#
二分类(Binary Classification)是一类分类任务,其目标是预测样本属于两个互斥类别中的哪一个,即正类(positive class)与负类(negative class)。
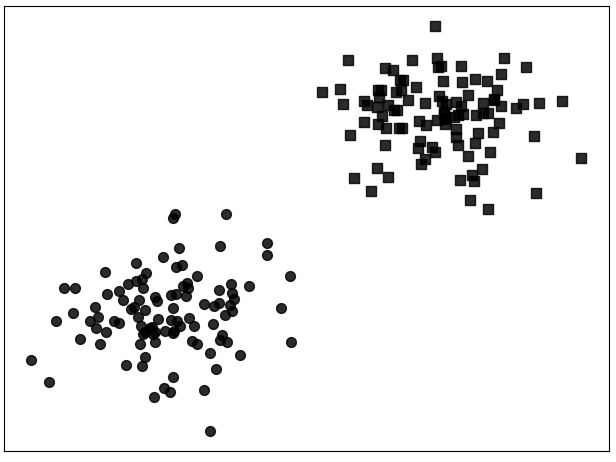
其本质是建立一个模型,对新输入的样本判定其应归属的具体类别,因此也常被表述为:需要建立一个模型来判断新输入的样本应属于哪个类别。

典型例子包括:
-
判断邮件是否为垃圾邮件(正类)或非垃圾邮件(负类)。
-
根据医学症状判断一个人是否患有某种疾病(正类)或未患该病(负类)。
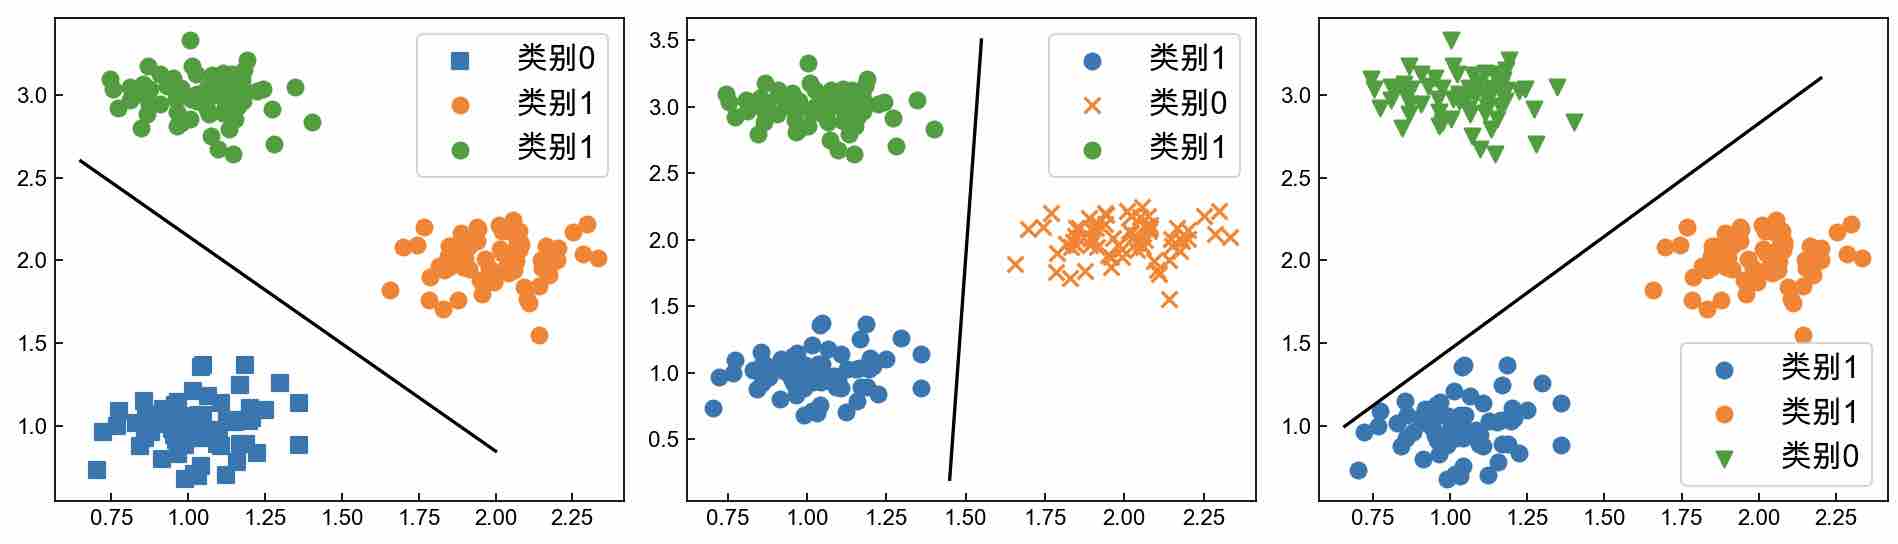
二分类与多分类(multi-class classification)相对。当类别数多于两个时,常通过 One-vs-all 策略,将其中一个类别与其余所有类别视为一个二分类任务进行训练,最终得到多个二分类模型。
相关概念#
-
逻辑回归(logistic regression):常用于解决二分类问题。模型首先输出样本属于正类的概率值,再根据一个阈值(通常默认 0.5)将概率转化为具体类别。
-
分类阈值(classification threshold):在二分类中,模型输出属于正类的概率后,需根据指定阈值判定是否为正类;该阈值默认为 0.5,也可根据实际情况调整以获得更好的预测结果。
评价指标#
在二分类中,常通过混淆矩阵中的 TP(真正例)、FP(假正例)、FN(假负例)、TN(真负例)来计算精确率(Precision)、召回率(Recall)、准确率(Accuracy)等指标,从而评估模型表现。
术语别名#
-
Binary Classification
-
二类分类
相关术语#
-
多分类
-
逻辑回归
-
分类阈值
-
混淆矩阵
-
精确率
-
召回率
-
准确率